产品亮点
你能用它做什么
- 编码场景:用 Claude Code 等工具通过 oMLX 做后端,快速恢复上下文
- 数据实验:同时加载 Qwen 和 MiniMax 模型做处理与分析
- 应用开发:借助工具调用支持和兼容 API 定制自己的 AI 应用
怎么用
- 1 下载 DMG 拖入应用程序文件夹,或按源码安装(需 Python 3.10 与苹果芯片)
- 2 让 oMLX 读取 Hugging Face 缓存和 LM Studio 文件夹,避免重复下载
- 3 按欢迎屏幕提示设置模型目录、启动服务器并下载第一个模型
- 4 在 Web 仪表盘用一键配置生成器复制命令,完成 API 配置
- 5 连接任意 OpenAI 兼容客户端,地址为 localhost:8000
适合谁使用
优点
- 缓存策略针对代理场景设计,首次响应时间改善明显
- 原生 macOS 应用,菜单栏即可启动、停止和监控
- API 兼容性好,现有 OpenAI 兼容客户端基本能直接用
局限
- 仅支持苹果芯片 Mac,其他平台用不了
- 需要一定动手能力,安装和模型配置偏工程化
- 价格信息在资料中未提及,采用 Apache 2.0 许可,具体以仓库说明为准
Omlx AI 是什么
oMLX 是一款基于 MLX 构建的原生 macOS 推理服务器,专为苹果芯片 Mac 设计,采用 Apache 2.0 许可。它要解决的核心问题是本地跑大模型时缓存反复失效:分页 SSD KV 缓存把热块留在内存、冷块按 LRU 写进 SSD,代理首次响应时间从 30 到 90 秒压到 5 秒以内。同时它提供 OpenAI 和 Anthropic 兼容 API,方便接入现有工具链。价格信息在资料中未提及,具体以仓库当前说明为准。
你能用它做什么
- 跑编码代理:作为 Claude Code 等工具的后端,快速恢复此前上下文。
- 多模型并行:同时加载 LLM、VLM、嵌入和重排器模型,内存不足时按 LRU 驱逐。
- 批量处理请求:连续批处理在并发度为 8 时生成速度最高提升 4.14 倍。
- 工具调用:支持 JSON、Qwen、Gemma、GLM、MiniMax 等格式,并提供 MCP 集成。
适合谁使用
- 编码人员:不想在每次会话切换后干等缓存重建。
- 数据科学家:需要在一台机器上切换多种模型做实验。
- AI 开发者:想基于开源项目做定制和二次开发。
需要留意什么
它只支持苹果芯片 Mac,其他平台无法使用。安装和模型配置偏工程化,需要一定动手能力,Windows 用户更无缘。免费规则可能变动,采用 Apache 2.0 许可,具体条款以仓库当前说明为准。
常见问题
oMLX 只能用在 Mac 上吗?
是的。它是专为苹果芯片 Mac 设计的原生 macOS 应用,源码安装同样要求苹果芯片。
首次响应为什么能这么快?
它用分页 SSD KV 缓存把先前看到的前缀持久化到磁盘,请求和重启时可直接恢复,不必重新计算。
支持哪些客户端?
提供 OpenAI 和 Anthropic 兼容 API,官方提到可与 Claude Code、OpenClaw、Cursor 等工具及任何 OpenAI 兼容客户端集成。
为什么说它免费
官网写明的免费方式: 免费使用免费
免费额度、试用天数与功能范围由官网决定,随时可能调整,请以官网为准。
产品截图
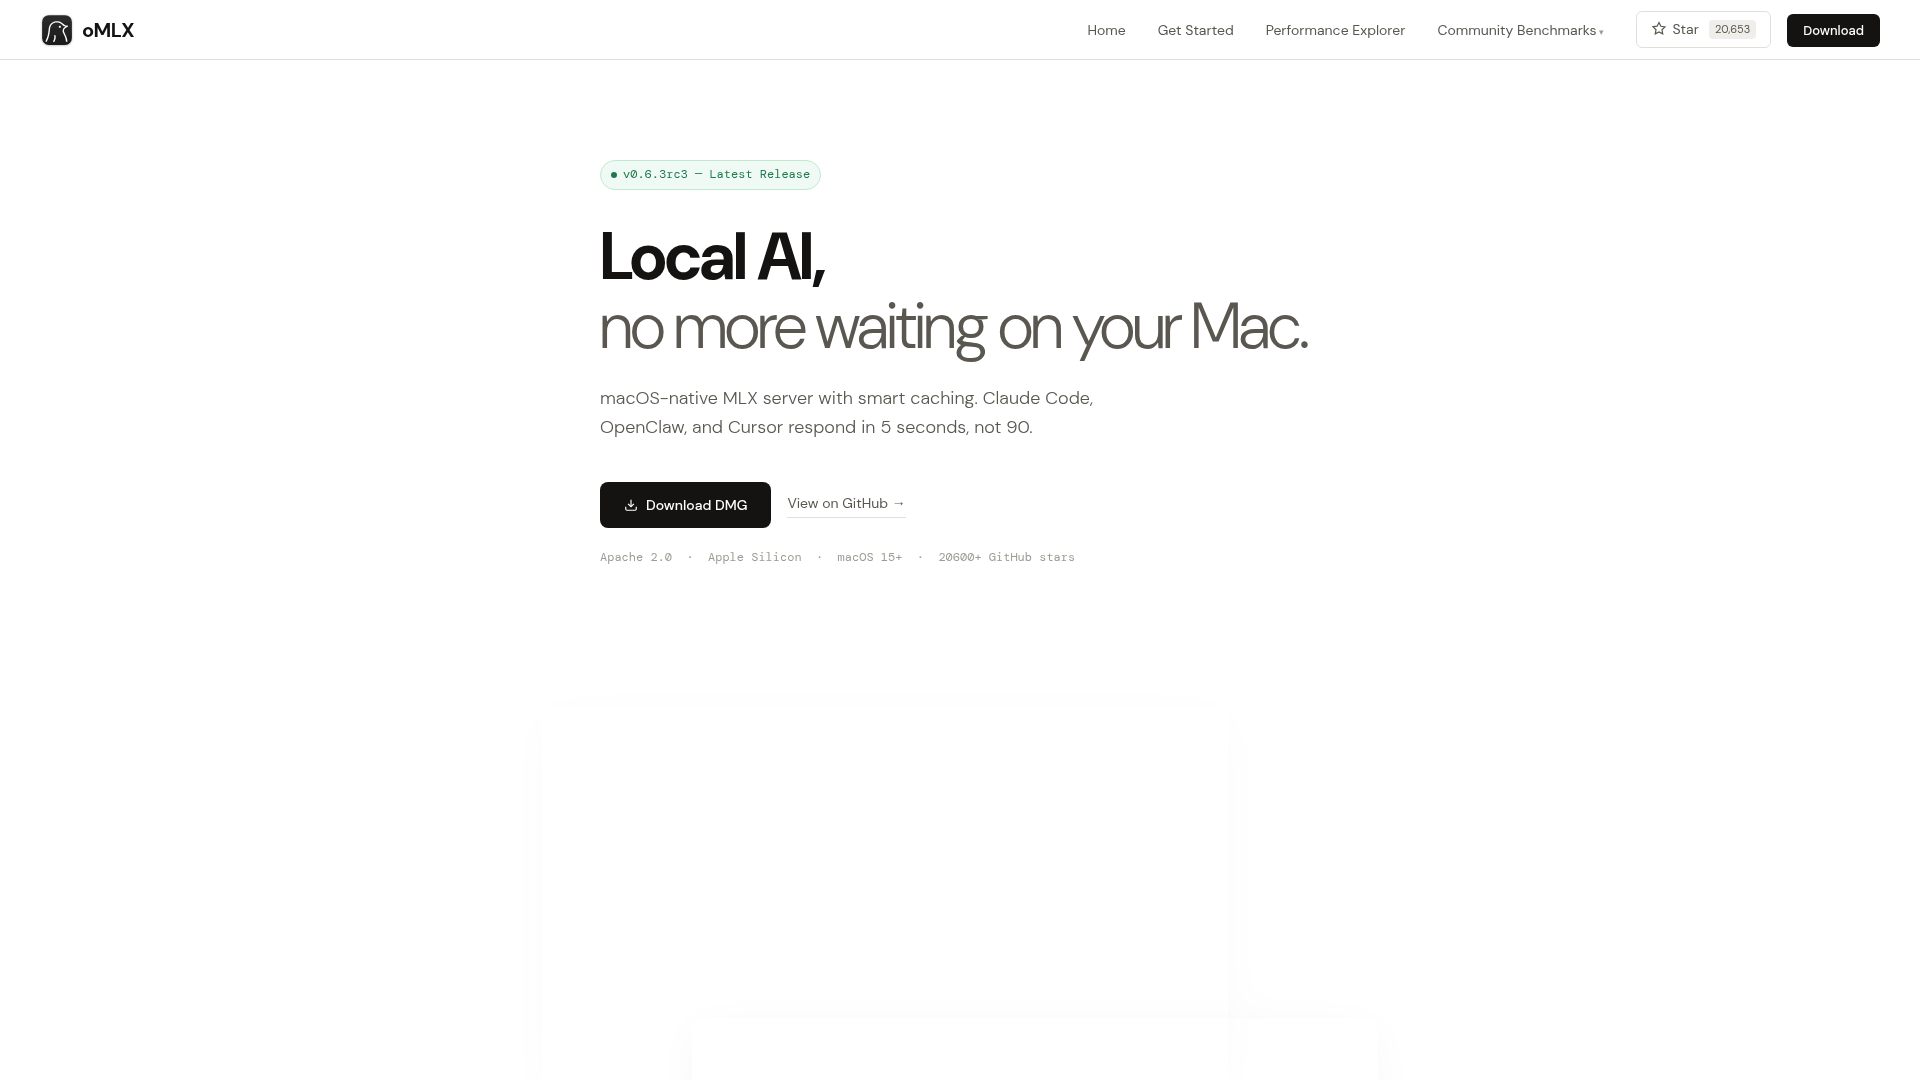
截图归档自收录页面,仅供预览参考。