产品亮点
用自然语言提示定义提取目标,不用写爬虫脚本。
网站改版后能自动适应,减少重写脚本的维护成本。
单次 API 调用即可提取整个网站的数据。
不设上下文窗口限制,可提取大量数据。
提供丰富的数据集成选项,可与 Zapier 等工具对接。
支持多语言和国际化网站的数据提取。
你能用它做什么
- B2B 获客:从多个公司网站提取联系信息,生成潜在客户名单。
- 竞品监控:跟踪竞争对手网站的价格变化,掌握市场动态。
- 内容分析:从新闻网站提取文章标题和摘要,用于研究。
怎么用
- 1 访问 Firecrawl Extract 官网,注册并登录账户。
- 2 根据需求选择合适的定价方案并订阅。
- 3 用自然语言提示定义需要提取的数据内容和格式。
- 4 通过 API 调用或网页界面发起提取任务。
- 5 获取结构化数据,导入到目标工具或平台。
- 6 需要持续更新的数据,可设置定期或自动提取任务。
适合谁使用
数据分析师与研究人员:需要大规模网页数据做分析。增长与销售团队:想批量获取企业联系信息做获客。开发者:希望用 API 把网页数据接进自己的系统。
优点
- 用自然语言描述需求即可,技术门槛比写爬虫低。
- 网站结构变化能自动适应,维护成本更低。
- 单次调用处理整个网站,效率高。
- 集成选项多,容易接进现有工作流。
局限
- 免费版额度有限,大规模提取需要付费方案。
- 提取结果需要人工校验,页面结构复杂的站点可能出错。
- 抓取行为需遵守目标网站的服务条款与 robots 规则。
- 涉及个人信息的抓取要注意合规,责任由使用者承担。
- 网站改版频繁或反爬严格的站点,效果可能不稳定。
Firecrawl Extract 是什么
Firecrawl Extract 是一个基于 AI 的数据提取工具,能把网站数据转换成结构化数据。它通过自然语言提示实现提取,用来解决传统爬虫脚本易碎、数据质量差的问题。定价从免费版到企业定制版,可按规模选择。
你能用它做什么
- 用自然语言提示描述需求,不用写复杂脚本。
- 单次 API 调用提取整个网站的数据,并支持大量数据提取。
- 网站结构变化时自动适应,减少重写爬虫的维护工作。
- 与 Zapier 等工具对接,把结构化数据送进现有工作流。
- 处理多语言和国际化网站的数据。
适合谁使用
- 需要大规模网页数据做分析的研究与数据人员。
- 想批量获取企业联系信息做获客的增长与销售团队。
- 希望用 API 把网页数据接进自己系统的开发者。
需要留意什么
免费版额度有限,大规模或持续提取需要付费方案,具体以官网当前页面为准。页面结构复杂或改版频繁的站点,提取结果可能出现偏差,需要人工校验。抓取行为必须遵守目标网站的服务条款与 robots 规则,涉及个人信息的抓取还要注意合规问题,相关责任由使用者自行承担。上线前建议先小批量测试,再扩大范围。
常见问题
Firecrawl Extract 怎么用?
用自然语言提示定义要提取的数据内容和格式,再通过 API 或网页界面发起任务。
需要写爬虫脚本吗?
不需要,它通过自然语言提示实现提取,也声称能自动适应网站更新。
有免费版吗?
有,官方提到从免费版到企业定制版的多种方案,额度以官网为准。
能抓多大的站?
官方提到单次 API 调用可提取整个网站数据,并支持无上下文窗口限制的大量数据提取。
抓取数据要注意什么?
需要遵守目标网站的服务条款与爬虫规则,涉及个人信息时注意合规,责任由使用者承担。
为什么说它免费
官网写明的免费方式: 免费版免费
免费额度、试用天数与功能范围由官网决定,随时可能调整,请以官网为准。
产品截图
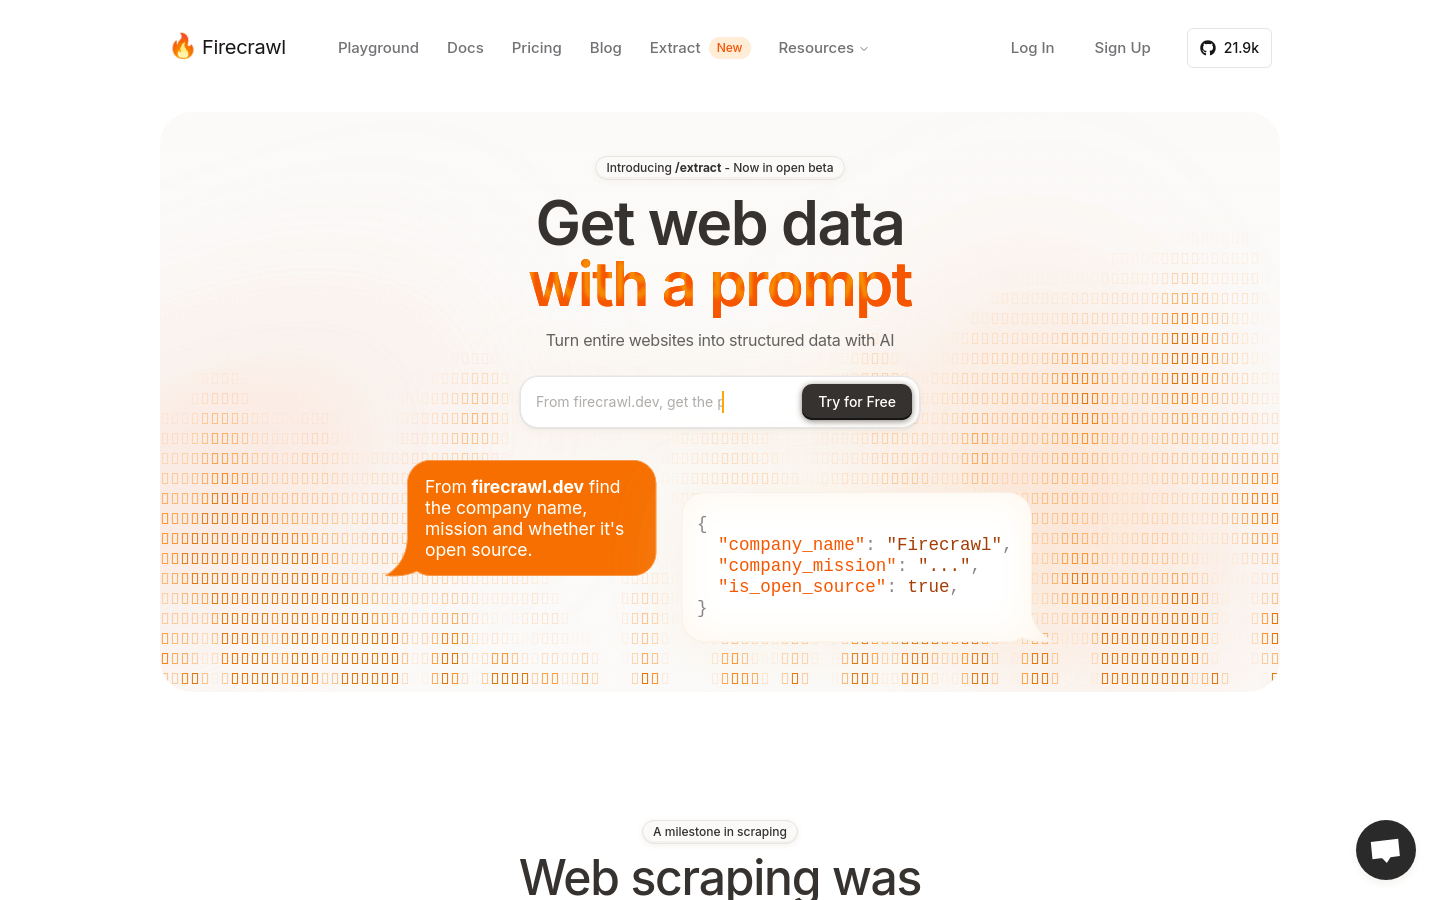
截图归档自收录页面,仅供预览参考。