产品亮点
音视频联合生成:一次前向同时出画面和声音
单张肖像驱动:只需一张正脸照片作为锚点
开源可商用:Apache 2.0许可,权重可下载
评测表现:公开评测中词错误率更低、人工偏好更高
你能用它做什么
- 内容创作者做虚拟主播口播视频
- 企业制作产品介绍宣传视频
- 教育工作者生成教学讲解视频
怎么用
- 1 准备正脸肖像照并输入脚本或音频
- 2 选择输出分辨率
- 3 提交任务生成说话视频
- 4 下载视频或按需自托管部署
适合谁使用
需要口播视频的内容创作者想快速出宣传素材的营销人员研究音视频生成的科研人员
优点
- 开源且Apache 2.0,可二次开发
- 单张照片即可驱动,门槛低
- 音视频一起生成,流程简化
局限
- 托管演示可能有额外条款,自托管要遵守许可
- 高分辨率与速度依赖硬件,显存不足会受限
- 生成真人形象需确保授权,避免伪造与侵权风险
DaVinci MagiHuman 是什么
DaVinci MagiHuman 是由 Sand ai 与上海交通大学 GAIR Lab 发布的 150 亿参数开源模型,采用 Apache 2.0 许可。它接收面部照片与文本或音频,在一次前向过程中联合生成口型同步且带匹配音频的说话视频,无需先做文本转语音再拼接。模型权重可免费使用与二次开发,托管演示可能有额外条款,自托管须遵守许可。
你能用它做什么
- 用一张正脸照片和脚本生成说话视频
- 让画面和声音一起生成,简化流程
- 支持多语言口型,具体取决于训练数据与版本
- 在H100级GPU上快速得到短片
适合谁使用
- 需要口播视频的内容创作者
- 想快速出宣传素材的企业营销人员
- 研究音视频生成的科研人员
需要留意什么
托管演示可能有额外条款,自托管要在 Apache 2.0 许可范围内使用。输出分辨率和速度依赖硬件,显存不足时只能降级。生成含真人形象的视频必须确保授权,避免伪造他人发言或侵犯肖像权,滥用风险由使用者承担。
常见问题
DaVinci MagiHuman 免费吗?
模型权重和代码遵循Apache 2.0许可,可在许可范围内免费使用与二次开发。
需要多少素材?
只需要一张正脸肖像照,配合脚本或音频。
能做什么用?
适合虚拟主播口播、产品介绍和教学视频等说话视频场景。
为什么说它免费
官网写明的免费方式: 免费
免费额度、试用天数与功能范围由官网决定,随时可能调整,请以官网为准。
产品截图
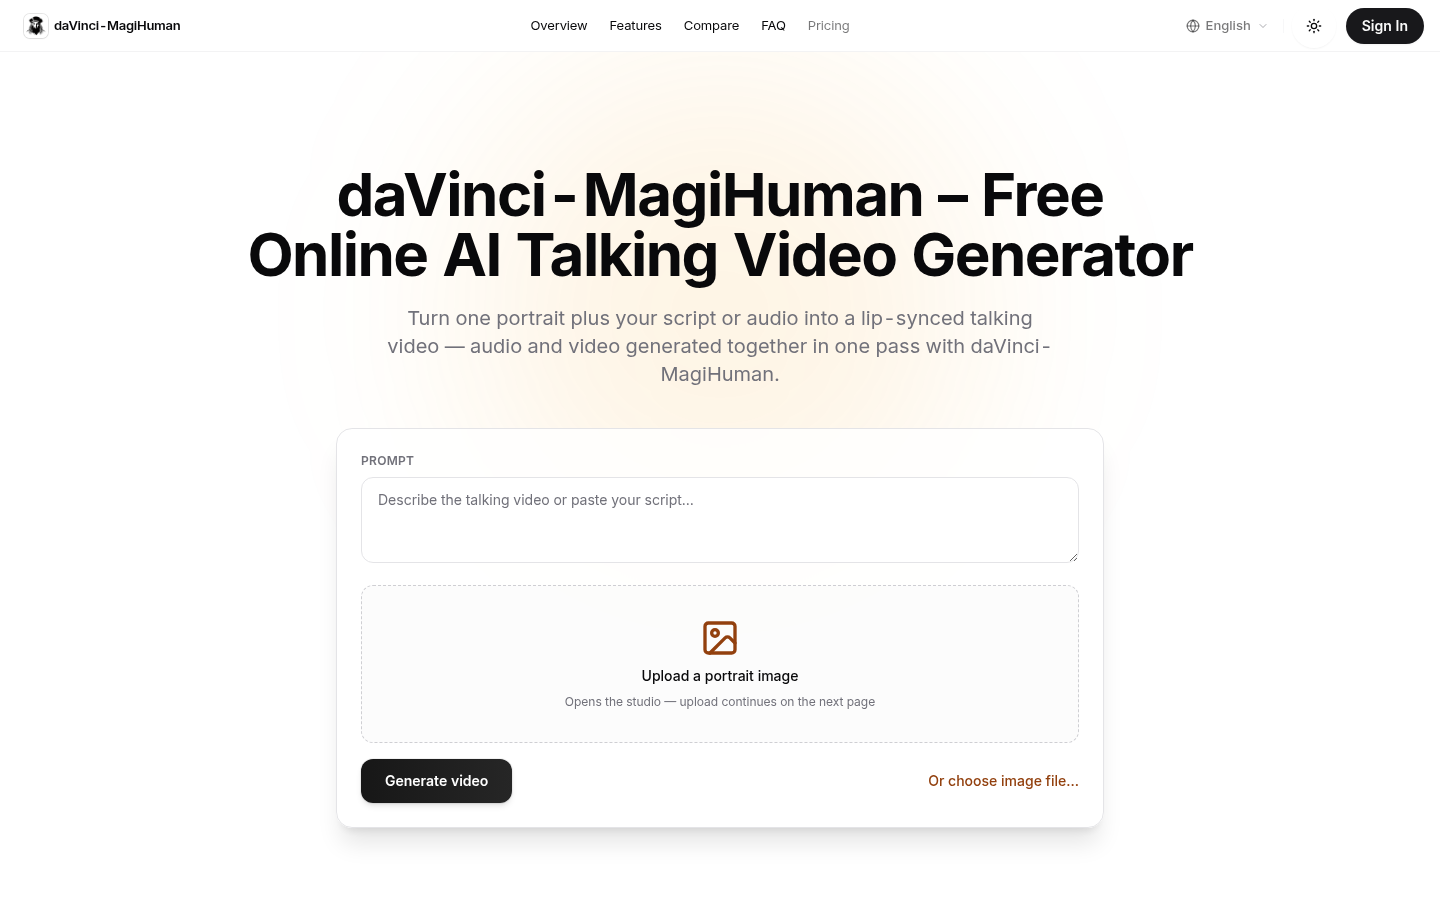
截图归档自收录页面,仅供预览参考。